Nordisk KI-hackaton 2026
For femte gang på rad har KI-miljøene ved nasjonalarkivene i Norden gjennomført sitt årlige hackaton, hvor vi har jobbet med ulike tekniske utfordringer sammen
I forkant av hackatonet ble vi delt inn i grupper på tvers av landegrensene, og vi lagde tolv oppgaver som gruppene kunne velge mellom. Her er oppgavene vi i Nasjonalarkivet valgte å jobbe med:
Hva er et hackaton?
Ordet «hackaton» er sammensatt av to ord: «hack», som i å løse noe på en enkel og lur måte (tenk Reodor Felgen), og «maraton», som indikerer at man holder på ganske intenst over en gitt tid. Tradisjonelle hackaton pågår gjerne i 24 timer uten stopp, men vi har pleid å dele det opp i to arbeidsdager, med litt tid utenom til å bli kjent.
Hvordan kan vi vurdere KI-ens transkripsjoner?
En av gruppene undersøkte hvordan man kan måle kvaliteten på automatisk håndskriftsgjenkjenning, eller HTR («handwritten text recognition»).
HTR brukes til å gjøre om håndskrevne dokumenter til maskinlesbar tekst. Det kan høres enkelt ut: Maskinen ser på et bilde av en side og forsøker å finne ut hvilke ord som står der, og hvor på siden de står. Men hvordan vet vi egentlig hvor godt den har gjort jobben?
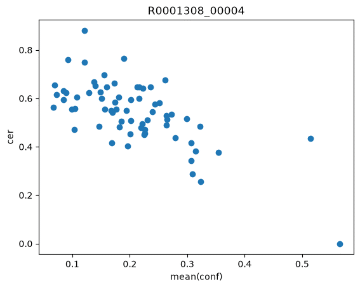
Det finnes flere måter å måle kvaliteten på, og i hackatonet sammenlignet deltakerne ulike kvalitetsmål: Det ene var å se på «confidence score», som sier hvor sikker KI-modellen selv er på resultatet. Den andre var «character error rate», hvor man har en fasit som KI-modellens resultat kan sammenliknes med. Vi fant at det faktisk var et samsvar mellom de to. Vi fikk også til å hente ut kvalitetsmålinger på ordnivå, som betyr at man for eksempel kan vurdere kvalitet på ord som det er sannsynlig at brukere søker etter.
Det høres kanskje litt akademisk ut, men dette er viktig i praksis: Hvis vi skal bruke maskinelt gjenkjent tekst til å gjøre store mengder historisk materiale søkbart, må vi vite hvor mye vi kan stole på resultatene.
Kan KI finne tekst som bør sladdes?
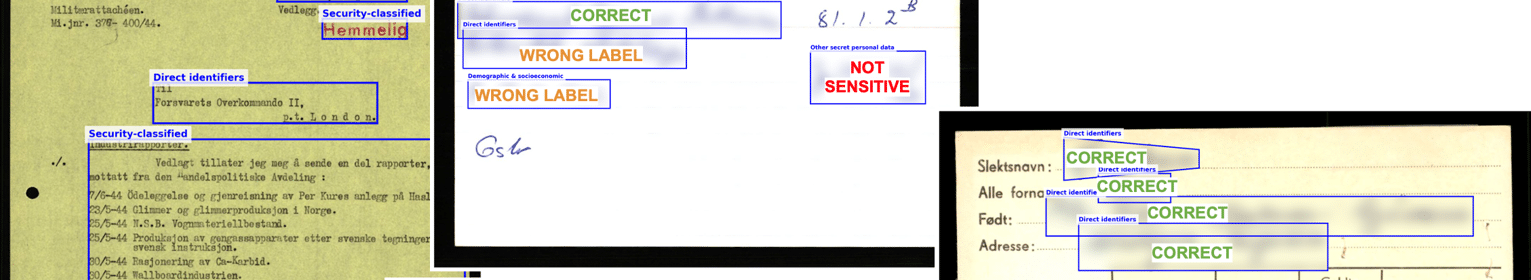
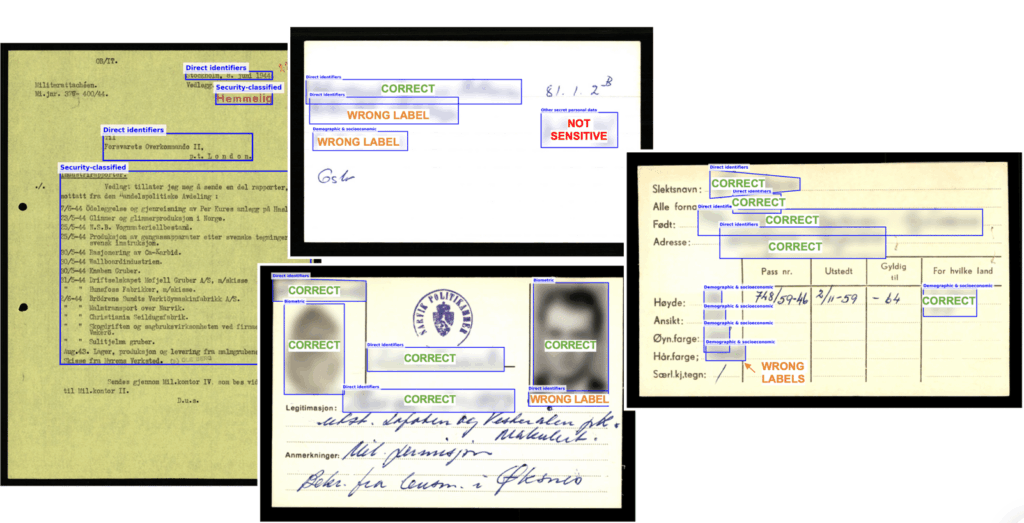
En annen gruppe jobbet med et problem som blir stadig viktigere når arkivmateriale skal gjøres tilgjengelig digitalt: Hvordan finner vi opplysninger som ikke bør publiseres? Det kan være personopplysninger eller andre sensitive opplysninger som må sladdes før materialet kan gjøres tilgjengelig.
Finland har allerede arbeidet med dette og laget en oversikt over sensitive kategorier, basert på blant annet GDPR og finsk lovgivning. Under hackatonet ble ulike modeller testet for å se om de kunne finne slike opplysninger i arkivmateriale.
En av modellene som ble testet, var Qwen, en såkalt stor visuell språkmodell. Det betyr enkelt forklart at modellen kan analysere selve bildet, ikke bare tekst som allerede er hentet ut fra bildet. Det er interessant for arkivene. Mange dokumenter finnes jo nettopp som bilder, og teksten i dem kan være vanskelig å maskinlese.
I testen ble Qwen brukt på 23 manuelt utvalgte arkivbilder fra flere land. Gruppen prøvde også å finjustere modellen, altså å spesialisere den på et nytt materiale, ved hjelp av elleve treningsbilder. Det siste forsøket ga en interessant erfaring: Finjusteringen gjorde modellen flinkere til å svare på en jevn og forutsigbar måte, men selve deteksjonen av sensitive opplysninger ble dårligere enn med grunnmodellen.
Elleve bilder er altfor lite til å trekke store konklusjoner. Men forsøket viser noe annet som er viktig: Qwen kan kjøre på vår egen infrastruktur, slik at vi ikke trenger skytjenester eller andre eksterne løsninger for å behandle sensitive data. Dette gjør jobben enklere og med færre avhengigheter, i tillegg til at det kan bli billigere i drift.
Gamle kart møter nye kart
En tredje gruppe tok for seg historiske kart. Gamle kart er interessante kilder, men de kan også være vanskelige å bruke sammen med dagens geografiske data. Stedsnavn kan ha endret seg, grenser kan være annerledes og kartene kan være laget etter helt andre prinsipper enn moderne kart.
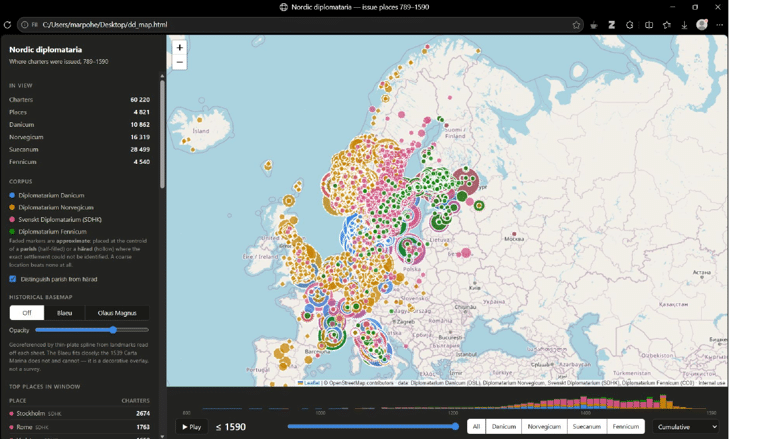
Gruppen undersøkte blant annet hvordan man kan hente ut stedsnavn og andre metadata fra historiske kart, og hvordan gamle kart kan plasseres geografisk. De sammenlignet også historiske stedsnavn med moderne kartdata. Det ble gjort forsøk på å koble historiske tekster til geografiske områder og visualisere hvor ulike tekster har sitt geografiske opphav.
Her finnes det mange muligheter videre. Et gammelt kart trenger ikke bare være et bilde man blar gjennom. Det kan bli en inngang til å utforske historiske steder, navn og sammenhenger på helt nye måter. Men først må metodene finpusses, og vi må finne ut hvilke bruksområder som faktisk gir mest verdi.
Hva om arkivene kunne snakke sammen?
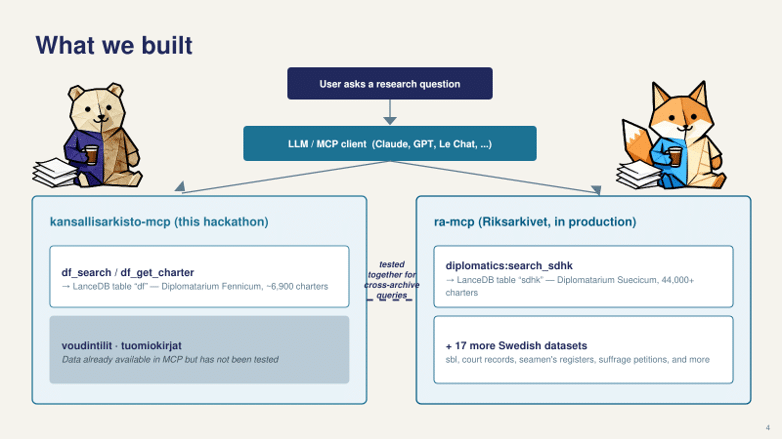
Den kanskje mest teknisk klingende oppgaven handlet om MCP, som står for «model context protocol». MCP-er kan brukes til å gi en KI-assistent kontrollert tilgang til bestemte datakilder og funksjoner. I stedet for at KI-en bare svarer ut fra det den allerede «vet», kan den få tilgang til informasjon fra systemer vi bestemmer at den skal bruke.
Under hackatonet undersøkte gruppen om det var mulig å lage en felles nordisk løsning basert på Sveriges eksisterende MCP-oppsett. Det ble blant annet satt opp en finsk MCP-tjeneste mot noen få kilder, og deltakerne testet om en KI-assistent kunne finne og kombinere informasjon fra flere kilder.
Dette er interessant fordi de nordiske arkivene har mye til felles, samtidig som informasjonen ligger i forskjellige systemer og hos forskjellige institusjoner. En felles måte å koble KI-verktøy til utvalgte arkivkilder på, kan gjøre det enklere å samarbeide på tvers av landegrensene.
Gruppen forsøkte også å vurdere kvaliteten på svarene man kan få fra en KI som henter ut data på denne måten. Hvordan vet vi at svarene faktisk bygger på riktige kilder, eller at ikke viktige opplysninger er utelatt? Testene som gruppen gjorde, viste at det kan være vanskelig å vurdere hvor gode svarene er, selv om KI-en altså har tilgang til faktiske arkivdata, siden det er vanskelig å skille mellom en vurdering av MCP-løsningen og selve KI-modellen.
Det viktigste vi tar med oss
Vårt første hackaton var i Stockholm i 2022, i forbindelse med Nordiske arkivdager. I år var vi tilbake i Riksarkivet i Sverige, etter å ha vært innom de andre hovedstedene i Norden, med unntak av Reykjavik. Utgangspunktet er at vi i Norden deler mange utfordringer og ser mange bruksmåter for KI, og vi ser at vi kan lære mye av å jobbe sammen på tvers av landegrensene. Det er også noen forskjeller mellom landene, som at vi har litt ulike organisasjonsformer, og at vi benytter ulike tekniske rammeverk. Men det viktigste er kanskje at likheter når det gjelder språk, historie og kultur er relevante for hvordan vi tar i bruk ny teknologi i arkivene våre.
Et hackaton handler ikke om å komme hjem med et ferdig produkt. Resultatet var prototyper, tester og ny kunnskap om hva som er verdt å jobbe videre med. Det er kanskje det som er den egentlige verdien av et hackaton: På to dager kan vi gå fra «mon tro om dette går?» til «dette ser faktisk mulig ut – nå vet vi hva vi må undersøke videre». Det handler om å finne ut hva som fungerer, og etter to dager sitter vi igjen med flere nyttige erfaringer.